人工智能(Artificial Intelligence, AI)已从学术前沿融入日常应用,而理解其基础概念与软件开发逻辑,是进入这一领域的第一步。本文浅谈AI领域的核心名词,并探讨人工智能基础软件的开发思路。
一、概念性名词浅谈
1. 人工智能(AI)
让机器模拟人类智能行为(如感知、推理、学习、决策)的科学与工程。它涵盖从符号逻辑到神经网络的多种范式。
2. 机器学习(Machine Learning)
AI的核心子集,指计算机通过数据自动改进算法性能,而非依靠硬编码规则。主要分为监督学习、无监督学习和强化学习。
3. 深度学习(Deep Learning)
使用多层神经网络(深度网络)自动提取特征的机器学习方法,在图像、语音、自然语言处理领域取得突破。
4. 神经网络(Neural Network)
受生物神经元启发的计算模型,由相互连接的节点(神经元)组成,通过权重和激活函数处理信息。
5. 大语言模型(LLM)
基于海量文本训练的超大规模神经网络,能生成连贯文本、回答问题,如GPT系列。其核心是Transformer架构。
6. 训练与推理
训练指使用数据调整模型参数(如梯度下降);推理指用训练好的模型对新数据预测或生成。
7. 数据集(Dataset)与特征(Feature)
数据集是模型的“教材”,特征是从原始数据中提取的有用属性,如像素颜色、词频。
8. 过拟合与欠拟合
过拟合:模型在训练集表现好,但泛化能力差;欠拟合:模型未学到数据规律,训练和测试都差。
二、人工智能基础软件开发
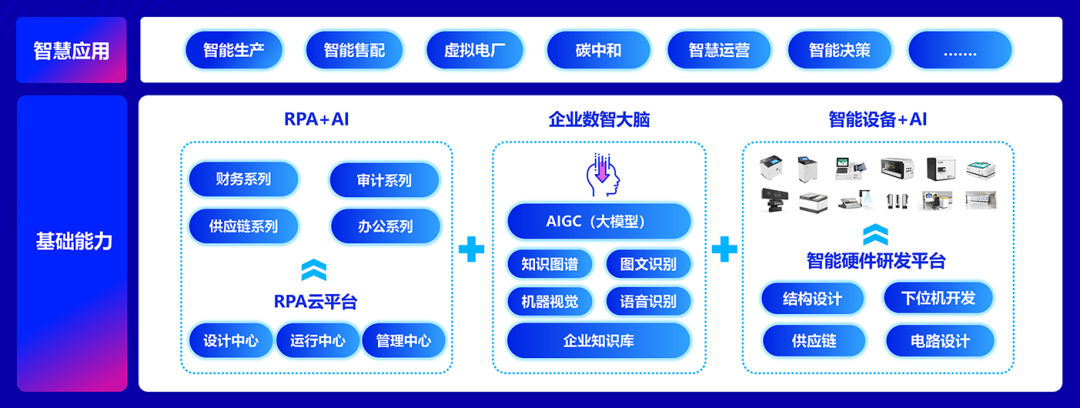
基础软件是AI的“操作系统”,支撑上层应用。开发此类软件需关注层次化体系。
1. 计算框架与库
—— 核心框架:TensorFlow、PyTorch、JAX,提供张量运算、自动求导、GPU加速,直接影响开发效率。
—— 数学库:NumPy、SciPy,是数据操作基础;CUDA、cuDNN支撑硬件加速度。
2. 数据管理与预处理中间件
AI性能依赖数据管道。基础软件需含ETL工具、数据标注平台、数据集管理(如Hugging Face Datasets)。
3. 模型编译与优化器
类似编译器的组件把高层模型图转换成硬件指令,例如TVM、ONNX Runtime、TensorRT。
4. 分布式训练与推理引擎
大型模型需要跨机器、跨GPU的分布式调度(如Horovod、PyTorch Distributed)。推理端需高并发、低延迟的引擎(如Triton Inference Server)。
5. 开发工具与运维
- 实验管理:MLflow、Weights & Biases跟踪实验。
- 运维(MLOps):Kubeflow、Metaflow实现模型部署与监控。
- 调试可视化:TensorBoard辅助调试。
6. 安全与隐私基础软件
需融入联邦学习、差分隐私、对抗样本防御。谷歌的TensorFlow Privacy是典型案例。
三、开发考量与趋势
基础软件开发需权衡性能(速度)、可用性(易用)、可扩展性与安全性。未来方向包括:
- 更高效的稀疏计算和低精度训练;
- 自动化机器学习(AutoML)降低接入门槛;
- 统一异构硬件生态(GPU/TPU/NPU)。
理解这些概念与层次,才能稳固建造AI高楼。从张量到Transformer,从PyTorch到生产集群,基础软件是AI无处不在的幕后功臣。
****
人工智能的爆发生长,依赖于那些看似枯燥的基础名词与软件开发工具。梳理清楚这些基石,我们才能更好地把握AI的来路与去程。